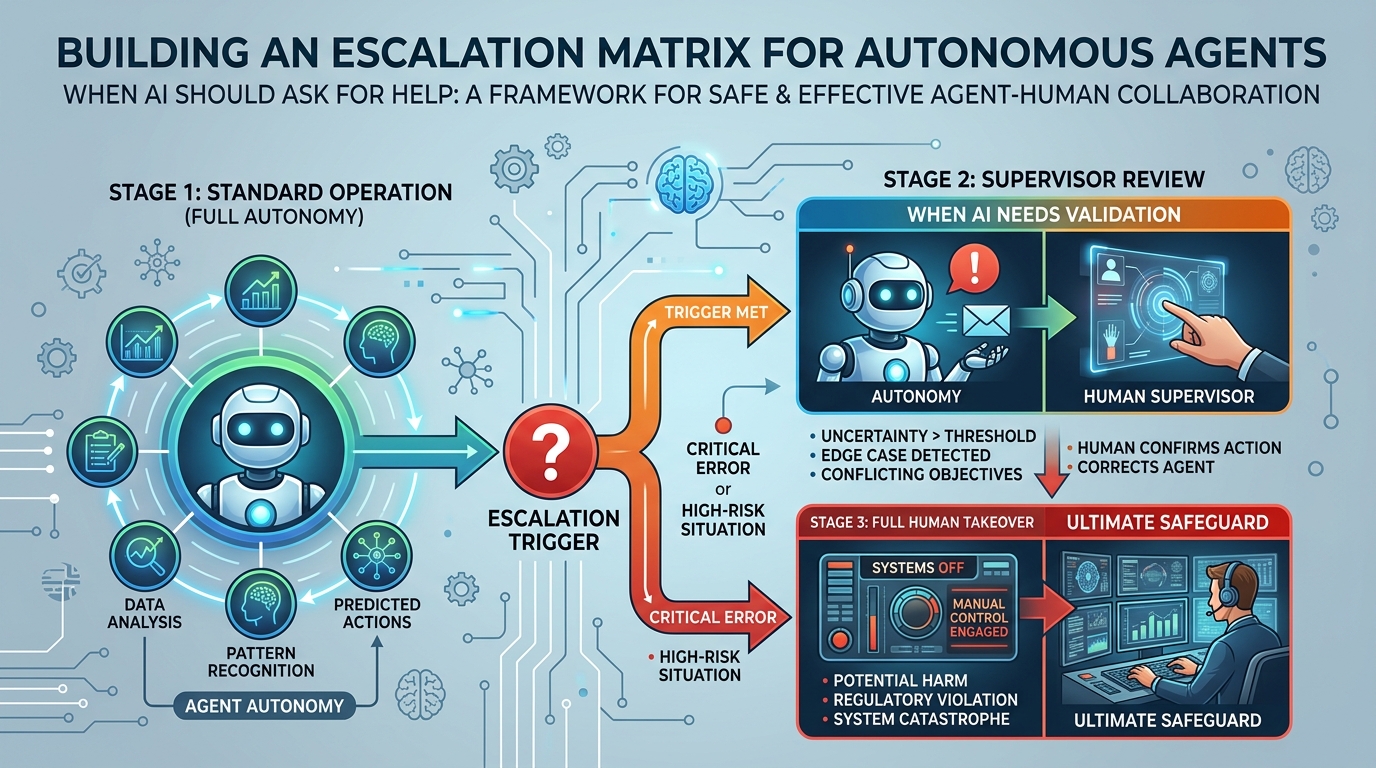
大多数部署自主客服智能体的团队都把顺序搞反了:先上线,等出问题了,再事后修补升级逻辑。而到那时,损失——一笔错误的退款、一位被告知要等 48 小时处理紧急问题的客户——已经造成了。在上线前就构建好升级机制,能够彻底扭转这种局面。
第一步:提取历史工单数据
在写下第一条规则之前,先提取六个月内已解决的工单,并按处理难度和涉及金额进行分类。在我们审查过的几乎每一个数据集中,都有一小部分意图类别占据了投诉和拒付案例中不成比例的大头——超过一定金额的退款、任何涉及法律或医疗诉求的问题,以及多方纠纷。从这些类别的硬性边界开始搭建你的矩阵,只有当你积累了足够多可供审计准确率的已解决对话记录后,才逐步扩大智能体在该类别中的自主权。
第二步:将矩阵写成表格,而非政策文档
每一行都应命名一个触发条件,并将其映射到一个对应动作。像"复杂问题"这样模糊的类别无法作为有效触发条件,因为你的智能体无法可靠地自我评估复杂程度;只有具体、可量化的信号才能作为决策的门槛。
| 触发条件 | 判定标准 | 处理动作 |
|---|---|---|
| 退款金额 | 低于 $50 | 自动处理 |
| 退款金额 | $50–$500 | 处理并记录留待审计 |
| 退款金额 | 超过 $500 | 升级至高级客服 |
| 受监管话题 | 检测到法律、医疗或财务建议相关措辞 | 立即升级,禁止自动处理 |
| 情绪 | 对话中情绪评分下降 2 分及以上 | 升级至高级处理队列 |
| 重复联系 | 同一问题 7 天内第 3 次联系 | 升级并标记供 CSM 复核 |
第三步:区分硬性限制与弹性限制
硬性限制无论智能体表现多好都不会改变——例如任何涉及受监管诉求的情况。弹性限制则有意设计为临时性的,随着团队对智能体在该类别中表现的信心增强而逐步放宽。如果把两者混在同一份未加区分的清单里,日后审查矩阵会变得更加困难,因为没人能一眼看出哪些行是安全护栏,哪些只是当前的谨慎之举。
第四步:与将要共同维护它的三方利益相关者一起起草
由拥有政策制定权的一方(通常是法务或合规部门)、拥有客户关系的一方(客服管理层)以及拥有模型的一方(AI 或工程团队)共同起草,矩阵的效果最好。仅由工程团队独自撰写的矩阵,往往会对非技术边缘案例升级不足;仅由合规部门独自撰写的矩阵,则往往会过度升级,以至于智能体几乎发挥不了什么价值。
第五步:每月对照"擦肩而过"的案例进行复核
智能体在没有帮助的情况下正确处理的每一次升级判断,都是放宽某个阈值的候选案例;而每一起事故,都是收紧某个阈值的候选案例。每月复核矩阵时,应参照一批边界案例样本——那些差点触发转交人工的对话——而不仅仅是那些真正触发了的案例,因为这些"擦肩而过"的情况才真正揭示了边界实际划在哪里。一行六个月未被改动的规则,不一定意味着调校得很好;它也可能只是上线以来从未有人再看过一眼的规则。
同时,建议为每一行记录智能体在采取行动前必须达到的置信度水平,以及遇到模棱两可情况时的处理方式——系统在真正不确定时应默认升级,还是即便置信度中等,某个低风险意图仍可安全地自动处理。将这一点明确写下来,可以避免一种常见的失败模式:置信度阈值被埋藏在一段几个月无人过问的提示词里;这也能让每月复核矩阵的人有一个具体的数字可以讨论,而不是凭一种模糊的感觉认为"机器人看起来还行"。
矩阵上线后由谁负责
没有指定负责人的矩阵往往漂移得最快,因为调整一个阈值需要有人先注意到某种模式、提出修改建议,再经过审核——而这样的工作只有在成为某人真正的职责时才能持续可靠地完成。指定单一负责人(通常也是负责升级队列人力配置的那个人)的团队,其每月复核的一致性远高于那些把矩阵当作无主共享文档对待的团队。这位负责人不需要独自批准每一项改动——第四步中描述的联合起草流程,仍然适用于任何具有实际政策分量的改动——但他们要确保复核按计划真正执行,而不是每次有更紧急的事情出现时就往后拖延一个季度。